
- بواسطة x32x01 ||
قولت أجرب المنتج الجديد بتاع DeepSeek - الـ Harness وأشوف بنفسي هل الضجة حوالينه تستاهل فعلًا، ولا الموضوع مجرد اسم جديد في عالم الـ AI Coding Agents.
عملت تجربة بسيطة جدًا: نفس الـ Task اتشغلت مرة باستخدام DeepSeek Harness، ومرة باستخدام AlphaCode.
والنتيجة كانت مفاجئة فعلًا. 👀
أما DeepSeek Harness فالوضع كان مختلف تمامًا.
بعد حوالي ساعتين إلا تلت، كان لسه شغال وبيحاول يوصل للحل.
وبعد الوقت ده بدأت أسأل نفسي:
والأرقام هنا كانت مثيرة للاهتمام جدًا:
يعني الفرق مش مجرد إن واحد خلص أسرع من التاني.
إحنا بنتكلم عن فرق كبير في:
المنافسة مش بالضرورة هتكون:
مين يقدر يحول الـ Intelligence إلى Execution حقيقي؟ 🧠➡️⚙️
يعني الـ Agent مش مطلوب منه بس إنه "يفكر".
المهم كمان إنه يعرف:
دي نقطة مهمة جدًا.
الاختبار ده عبارة عن تجربة واحدة على Task محددة، وبالتالي مينفعش نستخدم نتيجتها لوحدها علشان نحكم بشكل عام على كل قدرات النظامين.
ممكن تختلف النتيجة تمامًا حسب:
سرعة التنفيذ واستهلاك الموارد جزء أساسي من جودة الـ AI Agent، مش مجرد تفاصيل جانبية.
ممكن نبدأ نسأل أسئلة زي:
قد إيه استغرق علشان يخلص؟
استهلك قد إيه من الـ CPU والـ RAM؟
كام خطوة غير ضرورية نفذها؟
هل عرف يوقف نفسه لما المهمة خلصت؟
هل قدر يوصل لنفس النتيجة بأقل موارد؟
لأن الـ Intelligence لوحده مش كفاية.
القيمة الحقيقية بتظهر لما الذكاء يتحول إلى Execution سريع، مستقر، وفعال. ⚙️
ولسه بدري طبعًا نحكم من تجربة واحدة.
لكن بعد ما شفت الأرقام قدامي؟
هسكت شوية احترامًا وتقديرًا للـ 27 MB. 😄
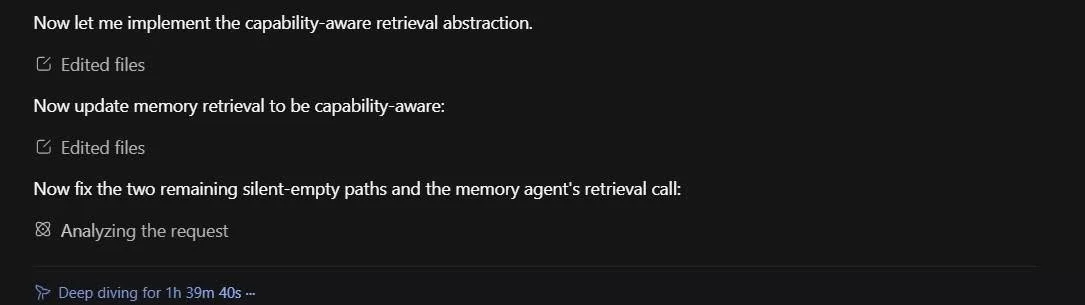
عملت تجربة بسيطة جدًا: نفس الـ Task اتشغلت مرة باستخدام DeepSeek Harness، ومرة باستخدام AlphaCode.
والنتيجة كانت مفاجئة فعلًا. 👀
⏱️ AlphaCode خلص في 10 دقايق
في التجربة، AlphaCode قدر يخلص الـ Task في حوالي 10 دقايق، ومن غير أخطاء ملحوظة في النتيجة.أما DeepSeek Harness فالوضع كان مختلف تمامًا.
بعد حوالي ساعتين إلا تلت، كان لسه شغال وبيحاول يوصل للحل.
وبعد الوقت ده بدأت أسأل نفسي:
- هو بيحل الـ Task فعلًا؟
- ولا دخل في Infinite Loop؟ 🔄
- ولا قرر يعمل Architecture جديدة للإنترنت؟ 😅
- ولا الـ Agent دخل في رحلة فلسفية لاكتشاف معنى الـ Code؟
💾 الفرق في استهلاك الـ RAM
بعد كده بصيت على استهلاك الموارد.والأرقام هنا كانت مثيرة للاهتمام جدًا:
| النظام | وقت التنفيذ | استهلاك RAM |
|---|---|---|
| AlphaCode | حوالي 10 دقائق | حوالي 27 MB |
| DeepSeek Harness | حوالي ساعتين إلا تلت وما زال يعمل | حوالي 2 GB |
إحنا بنتكلم عن فرق كبير في:
- Execution Efficiency
- Resource Usage
- Agent Behavior
- القدرة على الوصول للنتيجة بدون استهلاك موارد ضخمة
🤖 المشكلة مش دايمًا في حجم الـ AI Model
التجربة دي خلتني أفكر في نقطة مهمة جدًا بخصوص مستقبل AI Coding Agents.المنافسة مش بالضرورة هتكون:
ولا:مين عنده أكبر Model؟
ممكن المنافسة الحقيقية تكون في حاجة أهم:مين عنده أكبر Marketing Budget؟
مين يقدر يحول الـ Intelligence إلى Execution حقيقي؟ 🧠➡️⚙️
يعني الـ Agent مش مطلوب منه بس إنه "يفكر".
المهم كمان إنه يعرف:
- يخطط للمهمة بشكل منطقي.
- ينفذ الخطوات المطلوبة بكفاءة.
- يراجع النتيجة.
- يتجنب التكرار غير الضروري.
- يعرف إمتى المهمة خلصت.
- ويستخدم أقل قدر ممكن من الموارد لتحقيق النتيجة المطلوبة.
⚖️ هل ده معناه إن AlphaCode أفضل من DeepSeek Harness؟
مش بالضرورة.دي نقطة مهمة جدًا.
الاختبار ده عبارة عن تجربة واحدة على Task محددة، وبالتالي مينفعش نستخدم نتيجتها لوحدها علشان نحكم بشكل عام على كل قدرات النظامين.
ممكن تختلف النتيجة تمامًا حسب:
- نوع الـ Task.
- حجم المشروع.
- طريقة إعداد الـ Agent.
- الـ Model المستخدم.
- الأدوات المتاحة للـ Agent.
- عدد خطوات التنفيذ.
- البيئة اللي بيشتغل فيها.
- وطريقة قياس استهلاك الموارد.
سرعة التنفيذ واستهلاك الموارد جزء أساسي من جودة الـ AI Agent، مش مجرد تفاصيل جانبية.
🚀 المستقبل مش مجرد AI أذكى
كل ما الـ AI Coding Agents تبقى أقوى، هيبقى مهم إننا نقيس أكتر من مجرد جودة الكود النهائي.ممكن نبدأ نسأل أسئلة زي:
قد إيه استغرق علشان يخلص؟
استهلك قد إيه من الـ CPU والـ RAM؟
كام خطوة غير ضرورية نفذها؟
هل عرف يوقف نفسه لما المهمة خلصت؟
هل قدر يوصل لنفس النتيجة بأقل موارد؟
لأن الـ Intelligence لوحده مش كفاية.
القيمة الحقيقية بتظهر لما الذكاء يتحول إلى Execution سريع، مستقر، وفعال. ⚙️
ولسه بدري طبعًا نحكم من تجربة واحدة.
لكن بعد ما شفت الأرقام قدامي؟
هسكت شوية احترامًا وتقديرًا للـ 27 MB. 😄